本文用六种 NVIDIA、两种 AMD GPU 的实测数据讲 roofline 模型,所有数字、图、代码都在配套仓库里。主要结论:
- GPU 程序每搬 1 字节数据做的运算次数(FLOP/byte),超过硬件的 ridge point(算力与带宽之比,单位也是 FLOP/byte)就受算力限制,否则受带宽限制。
- 同一张卡上,每种精度、每种运算单元各有自己的算力峰值,ridge point 也随之不同:H100 上 FP16 Tensor Core 的 ridge point 是 255 FLOP/byte,CUDA Core 的 FP32 是 19.9 FLOP/byte。
- 大语言模型的线性层在 FP16/BF16 下,这个次数约等于一次送进去的 token 数。模型先把整段输入文本的所有 token 一起送进去(prefill),输入较长时受算力限制;之后每步只送进上一步生成的 1 个 token(decode),受带宽限制。
- decode 每步都要把全部权重读一遍,速度由带宽决定。多个请求一起算能共用这一遍读取,所以一起算的请求越多,平均每个 token 越快。
文中高亮:核心概念 结论 判断方法 实际应用
1. 时间的两个下界
Roofline 模型回答两个问题:一段 GPU 程序在一张卡上最快能跑多快;限制它的是搬数据还是做运算。
GPU 程序由一个个 kernel 组成。kernel 是在 GPU 上并行执行的一个函数,由 CPU 发出,每发出一次叫一次启动(launch)。kernel 运行时,硬件做两件事:在显存和芯片之间搬数据,用运算单元做算术。描述这两件事只需要四个量:
| 做运算 | 搬数据 | |
|---|---|---|
| kernel 的工作量 | \(W\):运算次数(FLOP) | \(Q\):读写显存的字节数(byte) |
| 硬件每秒的上限 | \(F\):算力峰值(FLOP/s) | \(B\):显存带宽(byte/s) |
表 1:Roofline 模型的四个量。一次浮点加或乘计 1 FLOP。
做完 \(W\) 次运算至少要 \(W/F\) 秒,搬完 \(Q\) 字节至少要 \(Q/B\) 秒。kernel 要等两件事都做完才结束,所以它的运行时间
\[T \ge \max\!\left(\frac{W}{F},\ \frac{Q}{B}\right)\]运算和搬运由不同的部件完成,可以同时进行,所以实际时间可以接近两者中较大的那个。
两项谁大,等价于两个比值谁大:
\[\frac{W}{F} > \frac{Q}{B} \iff \frac{W}{Q} > \frac{F}{B}\]\(W/Q\) 只和 kernel 有关,\(F/B\) 只和硬件有关,下面两节分别讲。整个模型就是比较这两个比值。
2. Arithmetic intensity
Arithmetic intensity(算术强度)\(I = W/Q\) 是 kernel 每搬 1 字节做的运算次数,单位 FLOP/byte。它只由运算的形状和精度决定,可以由公式直接算出。
矩阵乘。 矩阵乘(英文常写作 GEMM)\(X_{M\times K} \cdot A_{K\times N} = Y_{M\times N}\):\(Y\) 有 \(MN\) 个元素,每个做 \(K\) 次乘和 \(K\) 次加,所以 \(W = 2MNK\)。\(Q\) 按每个矩阵各读或写一次计算,共 \(MK + KN + MN\) 个元素。
一个元素占的字节数记为 sizeof:FP64(double)是 8,FP32(float)是 4,FP16 和 BF16 是两种半精度格式,都是 2。于是
\[I = \frac{2MNK}{\text{sizeof} \cdot (MK + KN + MN)}\]四种常见运算。 逐元素运算 \(y = x \cdot a + b\)(\(x\)、\(y\) 是数组,\(a\)、\(b\) 是常数)对每个元素读 1 次、写 1 次,做 1 次 FMA(fused multiply-add,一条指令完成一次乘和一次加,计 2 FLOP),所以 \(I = 1/\text{sizeof}\)。另外三种是不同形状的矩阵乘,由上式化简;瘦矩阵指 \(M\) 远小于 \(N\) 和 \(K\),这时分母约等于 \(\text{sizeof} \cdot KN\)。
| 运算 | \(I\)(FLOP/byte) | FP32 | FP16 |
|---|---|---|---|
| 逐元素 \(y = x \cdot a + b\) | \(1/\text{sizeof}\) | 0.25 | 0.5 |
| 方阵 \(M = N = K = n\) | \(2n / (3 \cdot \text{sizeof})\) | \(n/6\) | \(n/3\) |
| 瘦矩阵 \(M \ll N = K\) | \(2M / \text{sizeof}\) | \(M/2\) | \(M\) |
| 矩阵向量乘(GEMV)\(M = 1\) | \(2 / \text{sizeof}\) | 0.5 | 1 |
表 2:四种运算的 arithmetic intensity,单位 FLOP/byte。
从表 2 可以看到两点:
- 精度改变 \(I\)。 sizeof 在分母里,同一个矩阵乘从 FP32 换成 FP16,\(Q\) 减半,\(I\) 翻倍。
- 形状决定 \(I\) 的量级。 逐元素运算小于 1,方阵与 \(n\) 成正比,瘦矩阵与 \(M\) 成正比。
LLM 的线性层是瘦矩阵。 大语言模型(LLM)把文本切成 token(一个词或词的一部分)来处理,运算量最大的部分是线性层 \(Y = XA\):\(M\) 个 token 各是长度为 \(K\) 的向量,排成输入 \(X\);\(A\) 是 \(K \times N\) 的权重,即训练得到的模型参数。token 不多时 \(M\) 远小于 \(K\) 和 \(N\),所以FP16/BF16 线性层的 arithmetic intensity 约等于一次送进去的 token 数。\(M\) 增大到和 \(K\)、\(N\) 同一量级后,\(I\) 增长变慢。
3. Roofline 与 ridge point
Throughput(吞吐)\(P = W/T\) 是 kernel 每秒完成的运算数(FLOP/s)。代入 \(T\) 的下界:
\[P = \frac{W}{T} \le \frac{W}{\max(W/F,\ Q/B)} = \min(B \cdot I,\ F)\]对一张卡来说,\(F\) 和 \(B\) 是常数,上界只随 \(I\) 变化。把它画成 \(I\) 的函数,是一条先斜后平的线,形状像屋顶(roof),所以叫 roofline:
- 斜段:\(I\) 小时上界是 \(B \cdot I\),时间由带宽决定,称为 memory-bound;
- 平段:\(I\) 大时上界是 \(F\),时间由算力决定,称为 compute-bound;
- ridge point:两段在 \(I^* = F/B\) 相交。\(I^*\) 就是第 1 节里硬件一侧的比值,kernel 的 \(I\) 小于 \(I^*\) 是 memory-bound,大于 \(I^*\) 是 compute-bound。
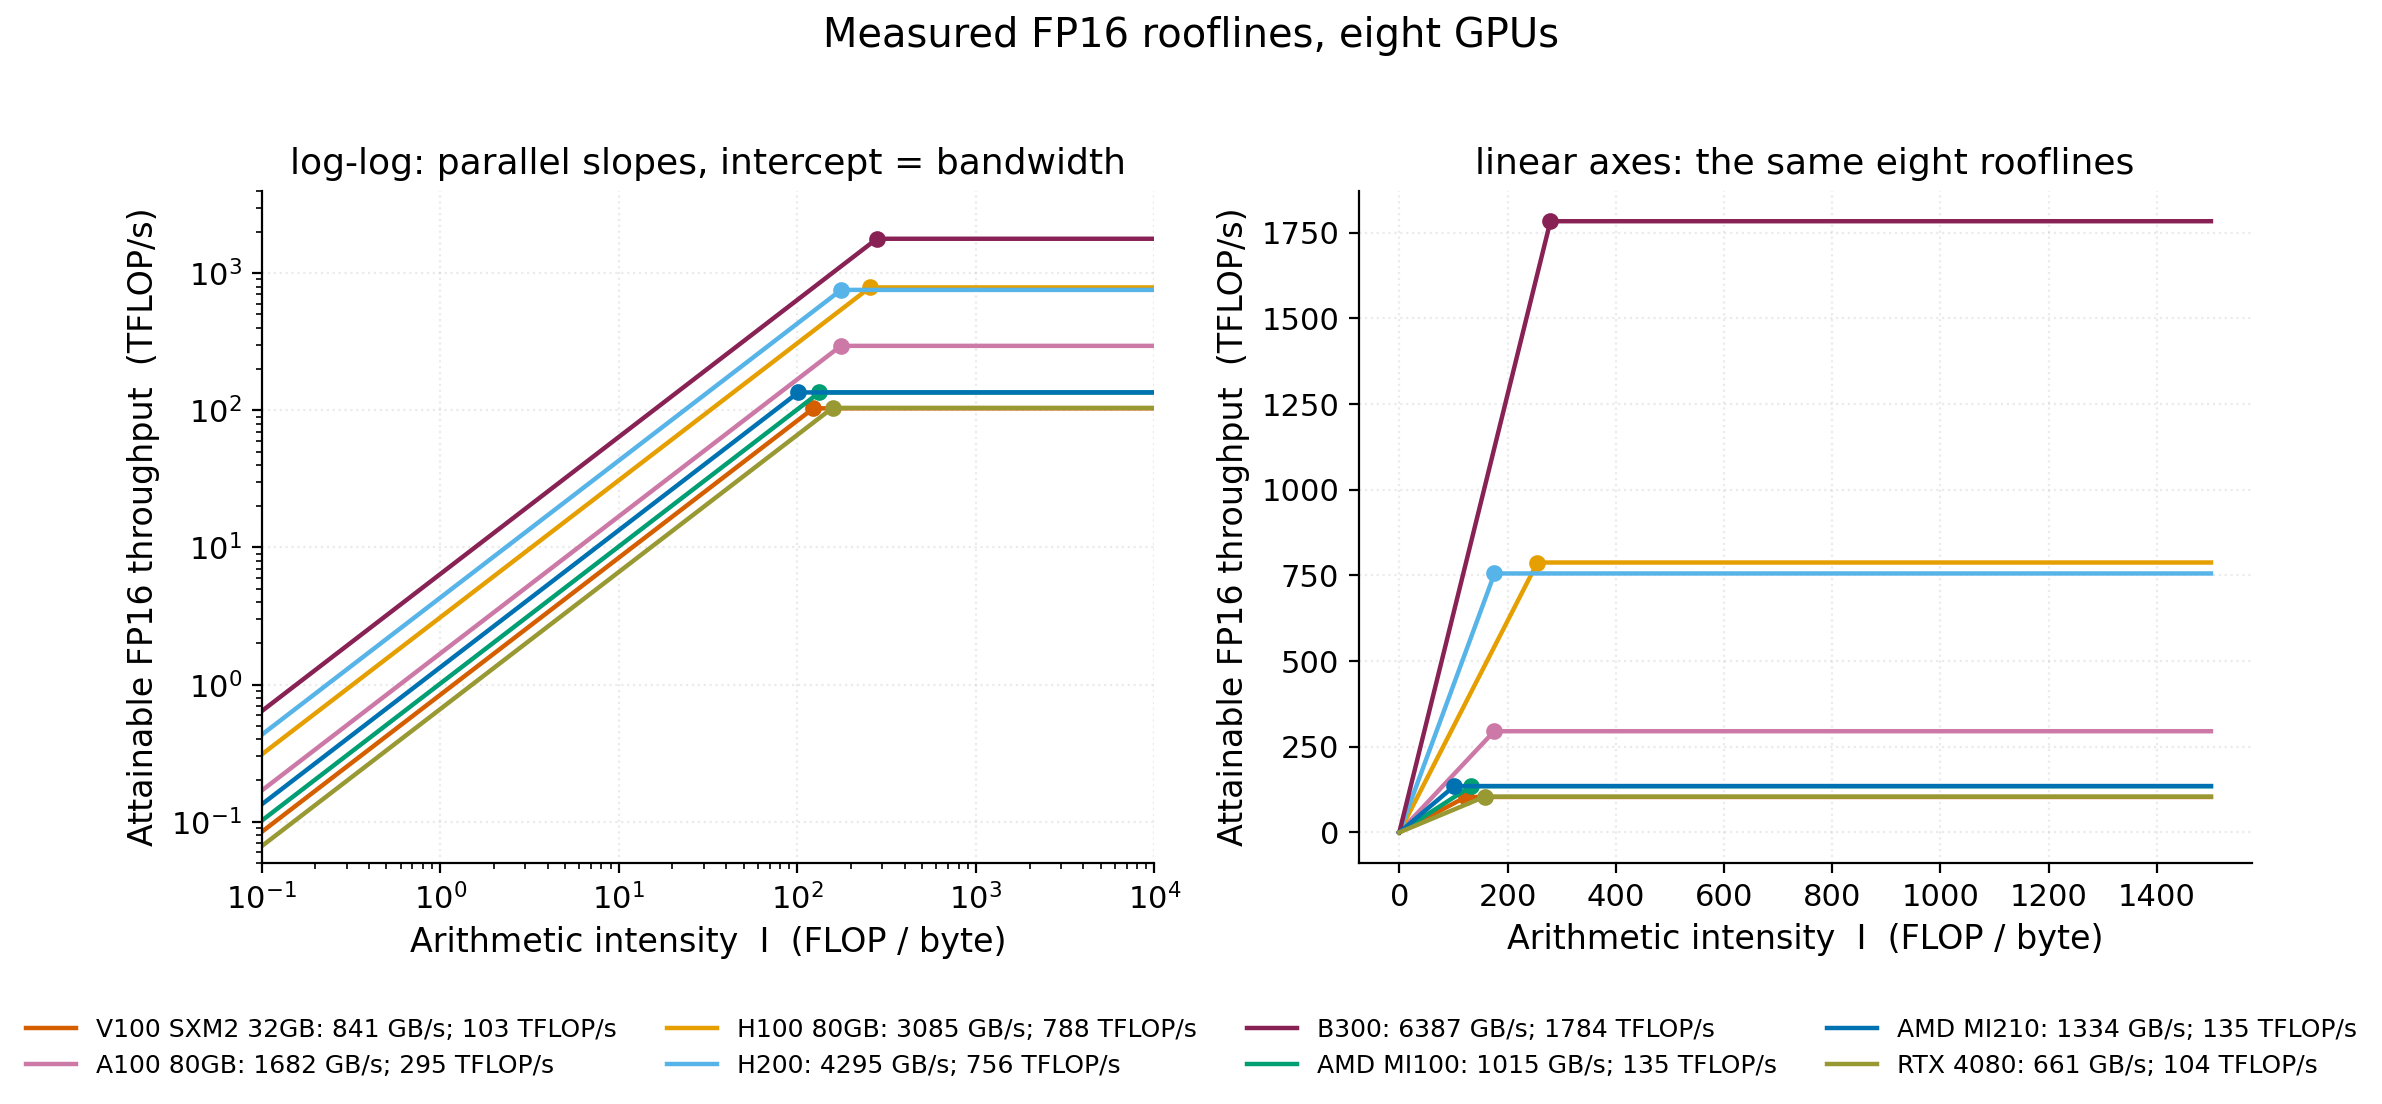
\(I\) 从零点几到上千,跨好几个数量级,所以 roofline 通常画在双对数坐标里。取对数后斜段是 \(\log P = \log I + \log B\),斜率恒为 1,带宽只改变截距,所以各卡的斜段互相平行。
八张卡的 roofline
图 1 和表 3 是八张卡实测的 FP16 roofline。前五张是 NVIDIA 的数据中心卡,按发布时间从 2017 年的 V100 排到 2025 年的 B300;MI100 和 MI210 是 AMD 的数据中心卡,分别在 2020 年和 2022 年发布;RTX 4080 是面向游戏的消费级显卡。
| GPU | \(B\) GB/s | \(F\) FP16 TFLOP/s | \(I^*\) FLOP/byte |
|---|---|---|---|
| V100 SXM2 32GB | 841 | 103 | 123 |
| A100 80GB | 1682 | 295 | 176 |
| H100 80GB | 3085 | 788 | 255 |
| H200 | 4295 | 756 | 176 |
| B300 | 6387 | 1784 | 279 |
| AMD MI100 | 1015 | 135 | 133 |
| AMD MI210 | 1334 | 135 | 101 |
| RTX 4080 | 661 | 104 | 158 |
表 3:八张卡的实测带宽、FP16 算力和 ridge point。\(F\) 的单位是 TFLOP/s、\(B\) 是 GB/s,所以 \(I^* = 1000 \times F / B\)(用未取整的值计算)。
- 算力涨得比带宽快。 从 V100 到 B300,\(F\) 涨了 17 倍,\(B\) 涨了 7.6 倍,\(I^*\) 向右移。同一个 kernel 在新卡上更容易是 memory-bound。
- H200 和 H100 的 roofline 相交。 H200 的带宽比 H100 大 39%,算力略低(756 对 788 TFLOP/s),两条 roofline 在 \(I = 245\) FLOP/byte 处相交:\(I\) 小于 245 时 H200 的 roofline 更高,更大时 H100 略高。一个 kernel 在哪张卡上的上界更高,取决于它的 \(I\) 落在交点哪一边。
- \(F\) 相同时,\(B\) 越大,\(I^*\) 越小。 AMD 的 MI100 和 MI210 的 FP16 算力都是 135 TFLOP/s,MI210 的带宽高 31%(1334 对 1015 GB/s),\(I^*\) 从 133 降到 101 FLOP/byte。
- RTX 4080 更偏 memory-bound。 它的 \(F\) 和 V100 几乎相同,\(B\) 是 V100 的 79%,所以 \(I^*\) 更大(158 对 123 FLOP/byte)。
同一张卡上的多个 roofline
同一张卡上,每种精度、每种运算单元各有自己的 \(F\),也就各有自己的 roofline。
Tensor Core 是专门做小块矩阵乘的单元,算力远高于执行 FMA 指令的 CUDA Core(普通运算单元)。矩阵乘可以用 Tensor Core;逐元素运算、归一化(LayerNorm)、softmax 这些 LLM 里常见的非矩阵乘运算只能用 CUDA Core。
TF32 是 Tensor Core 用较短的尾数执行 FP32 矩阵乘的模式,精度略低,通常默认关闭,所以默认的 FP32 矩阵乘对应表 4 中“关闭 TF32”那一行。
| H100 上的运算路径 | \(F\) TFLOP/s | \(I^*\) FLOP/byte |
|---|---|---|
| FP16 矩阵乘,Tensor Core | 788 | 255 |
| TF32 矩阵乘,Tensor Core | 418 | 135 |
| FP64 矩阵乘,Tensor Core | 64.2 | 20.8 |
| FP32 FMA,CUDA Core | 61.5 | 19.9 |
| FP32 矩阵乘,CUDA Core(关闭 TF32) | 51.9 | 16.8 |
| FP64 FMA,CUDA Core | 32.9 | 10.7 |
表 4:H100 上六条运算路径的实测算力与 ridge point。两行 FMA 的测法见第 4 节。
- 按 kernel 实际用的路径判断。 分析一个 kernel,要用它实际使用的那条运算路径的 roofline。一个 \(I = 50\) FLOP/byte 的 kernel,用 FP16 Tensor Core(\(I^* = 255\))是 memory-bound,用 FP32 CUDA Core(\(I^* = 19.9\))就是 compute-bound。FP32 的 LayerNorm、softmax 走 CUDA Core,对应的 \(I^*\) 是 19.9。
- FP64 矩阵乘比 FP32 矩阵乘快。 H100 的 FP64 矩阵乘能用 Tensor Core(64.2 TFLOP/s),关闭 TF32 的 FP32 矩阵乘只能用 CUDA Core(51.9)。后者又比 FP32 FMA(61.5)低,因为矩阵乘的 kernel 除了乘加,还要执行读写数据和同步的指令。能接受精度略低时,打开 TF32 让 FP32 矩阵乘也走 Tensor Core,算力从 51.9 升到 418 TFLOP/s。
- B300 上各路径相差最大。 它的 FP16 Tensor Core 是 1784 TFLOP/s,FP64 矩阵乘是 1.05 TFLOP/s。B300 面向低精度的 AI 计算,只配了很少的 FP64 单元,FP64 的 \(I^*\) 是 0.16 FLOP/byte,几乎所有 FP64 kernel 在它上面都是 compute-bound。
4. 带宽与算力峰值的测量
本文的 roofline 用的 \(F\) 和 \(B\) 都是在每张卡上测出来的,下面分别讲带宽和算力怎么测。
带宽
用只搬数据、几乎不做运算的 kernel 来测,例如读一个 512 MiB 的数组求和。
GPU 在显存之外还有一块片上缓存 L2,容量小但带宽高(A100 40 MiB、H100 50 MiB、RTX 4080 64 MiB)。测量时 kernel 要连续执行很多次;kernel 读写的数据总量(working set)装得进 L2 时,后几次要用的数据还留在 L2 里,测到的是 L2 的带宽。所以测显存带宽时,working set 要比 L2 大得多。图 2 是拷贝 kernel 测到的带宽随 working set 的变化。
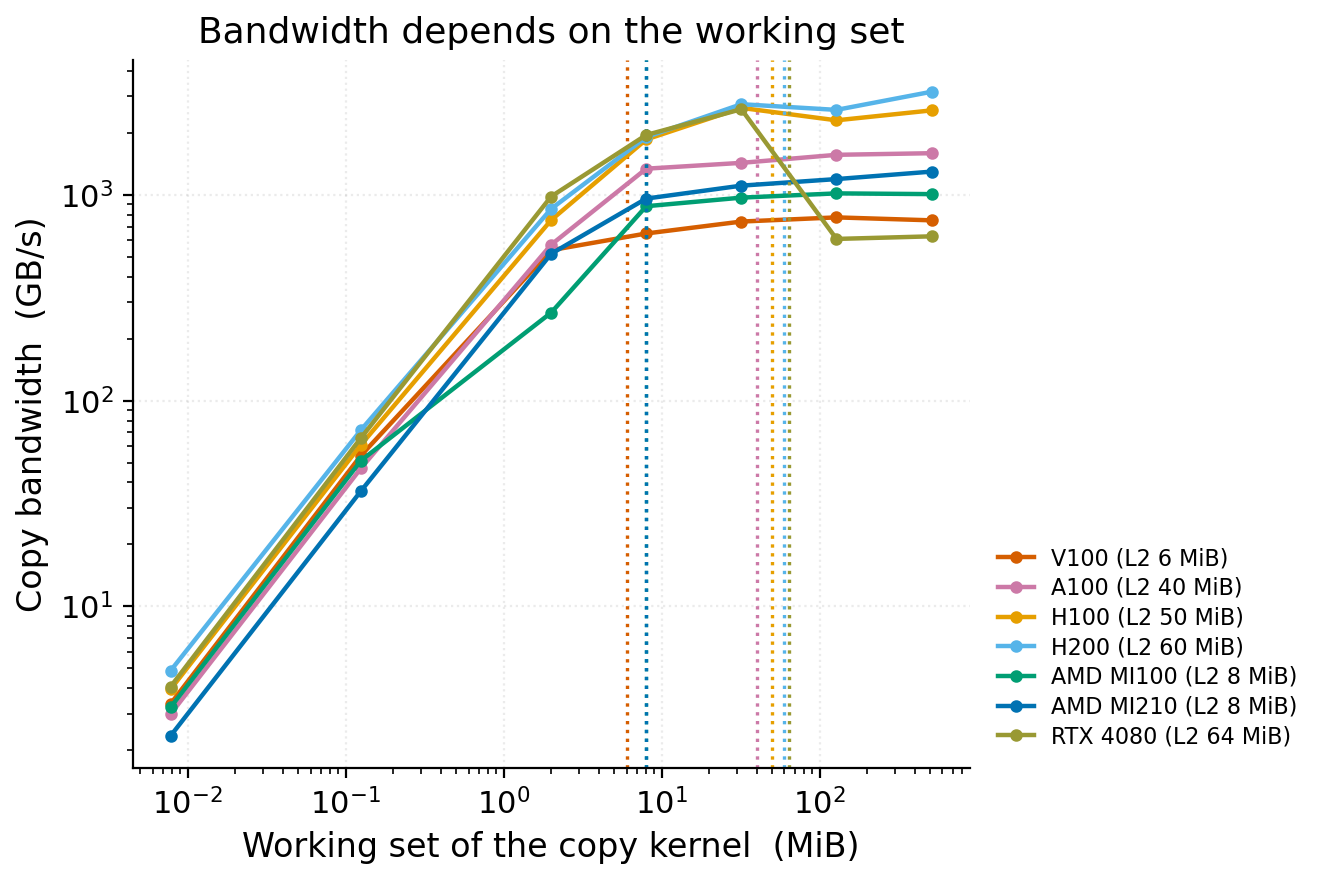
- 越过 L2 后测到的是显存带宽。 RTX 4080 在 32 MiB 时测到的 2600 GB/s 是 L2 的带宽,128 MiB 时的 610 GB/s 是显存的带宽。其余几张卡越过 L2 后带宽变化不大:A100、H100、H200 的显存带宽和 L2 差得不多;V100、MI100、MI210 的 L2 是 6 到 8 MiB,这么小的 working set 下时间主要是 launch overhead。
- working set 很小时,时间是 launch overhead。 几 KiB 到几 MiB 时,带宽随 working set 成比例上升。kernel 每次启动都有几微秒的固定开销(launch overhead),这一段的时间几乎全是它:数据量翻倍而时间不变,算出的带宽就翻倍。
不同写法的 kernel 测到的带宽不一样:H100 上读 512 MiB 求和的只读 kernel 是 3085 GB/s,拷贝 kernel 是 2568 GB/s。roofline 的 \(B\) 取所有只搬数据的 kernel 里最高的值。
算力
用 cuBLAS(NVIDIA 的矩阵乘库)跑两组矩阵乘:
- 方阵,\(n\) 从 256 到 8192;
- 瘦矩阵,固定 \(N = K = 8192\),\(M\) 从 1 翻倍取到 2048,再以 \(M = 8192\) 作为终点,下文称为 M sweep。
\(F\) 取所有形状中最高的 throughput,H100 FP16 是 788 TFLOP/s。
直接测出 roofline 的形状
上面的 \(B\) 和 \(F\) 来自不同的 kernel。还可以用同一个 kernel 扫过整个横轴,检验 throughput 是否真的沿着 \(\min(B \cdot I,\ F)\) 变化。
做法是把第 2 节的逐元素运算改成:每个元素读进来以后,在寄存器里连续做 \(R\) 次 FMA 再写回,下文称为 FMA sweep。每个元素做 \(2R\) FLOP,读写仍各 1 次,所以
\[I = \frac{2R}{2 \cdot \text{sizeof}},\qquad \text{FP32: } I = R/4,\quad \text{FP64: } I = R/8\]\(R\) 从 1 取到 2048,数组读写共 512 MiB,远大于 L2。
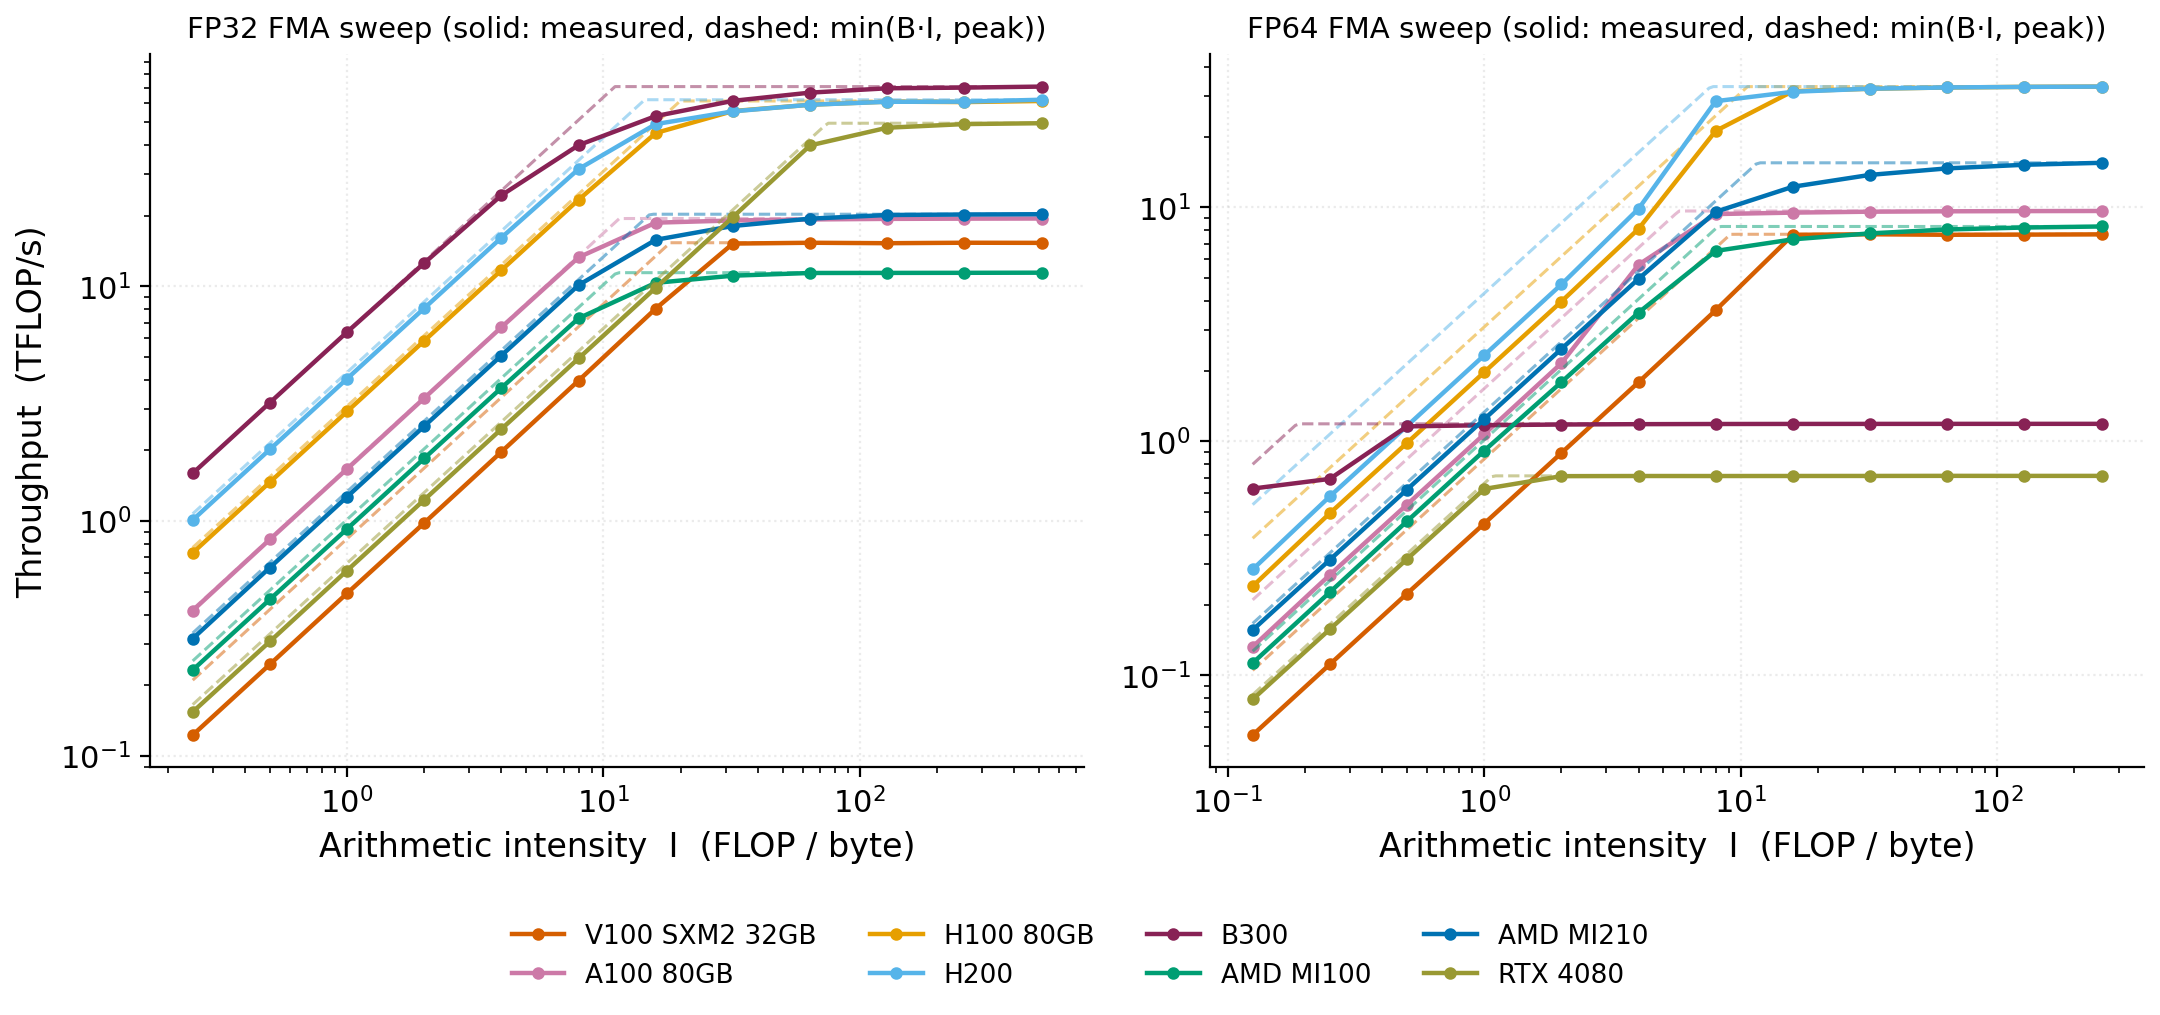
- 斜段:时间约等于搬 512 MiB 的时间,\(R\) 翻倍时运算量翻倍、时间不变,throughput 翻倍。
- 平段:运算单元已经满负荷,\(R\) 翻倍时时间也翻倍,throughput 不再变。
- ridge point 附近是圆角:实测比虚线低,因为搬运和运算不能完全同时进行。
- 部分曲线的斜段偏低:V100 的 FP32 和 FP64,以及 A100、H100、H200 的 FP64,这个 kernel 用到 53% 到 66% 的显存带宽,其余大都在 88% 以上。这是 kernel 写法的限制,不影响平段的高度。
FMA sweep 平段的高度就是普通运算单元(NVIDIA 卡上是 CUDA Core)的 \(F\):
| GPU | FP32 FMA TFLOP/s | FP64 FMA TFLOP/s |
|---|---|---|
| V100 SXM2 32GB | 15.3 | 7.7 |
| A100 | 19.4 | 9.7 |
| H100 | 61.5 | 32.9 |
| H200 | 62.2 | 32.9 |
| B300 | 70.8 | 1.19 |
| AMD MI100 | 11.4 | 8.3 |
| AMD MI210 | 20.3 | 15.5 |
| RTX 4080 | 49.4 | 0.71 |
表 5:八张卡普通运算单元的实测算力。
- 消费级显卡少的是 Tensor Core。 RTX 4080 的 FP32 FMA 是 A100 的 2.5 倍,FP16 Tensor Core 是 A100 的 35%。
- FP64 与 FP32 之比各不相同。 V100、A100、H100、H200 的 FP64 约是 FP32 的一半;MI100 和 MI210 是 73% 和 77%;B300 和 RTX 4080 配的 FP64 单元很少,FP64 在 1 TFLOP/s 上下。
5. 实测点与 roofline 的关系
有了 roofline,一个 kernel 就是图上的一个点:横坐标是它的 \(I\),纵坐标是实测 throughput \(W/T\)。从这个点可以读出两件事:
- 点在哪一段下方,决定该优化什么。 斜段下方时间的下界是 \(Q/B\),只和搬运的字节数有关;平段下方时间的下界是 \(W/F\),只和运算量与算力有关。所以在斜段下方要减少搬运的字节、提高 \(I\),在平段下方要换到更高的平段,例如 Tensor Core 或更低的精度。
- 点离 roofline 多远,说明还有多少空间。 点的纵坐标除以 roofline 在同一横坐标处的高度,就是 kernel 达到了上界的百分之几。达到 roofline 的 kernel 在实现上已经没有优化空间:在斜段上要更快只能提高 \(I\),在平段上只能换到更高的平段。
矩阵乘的实测点
图 4 把 cuBLAS 矩阵乘的实测点放到三张卡、三种精度各自的 roofline 下。
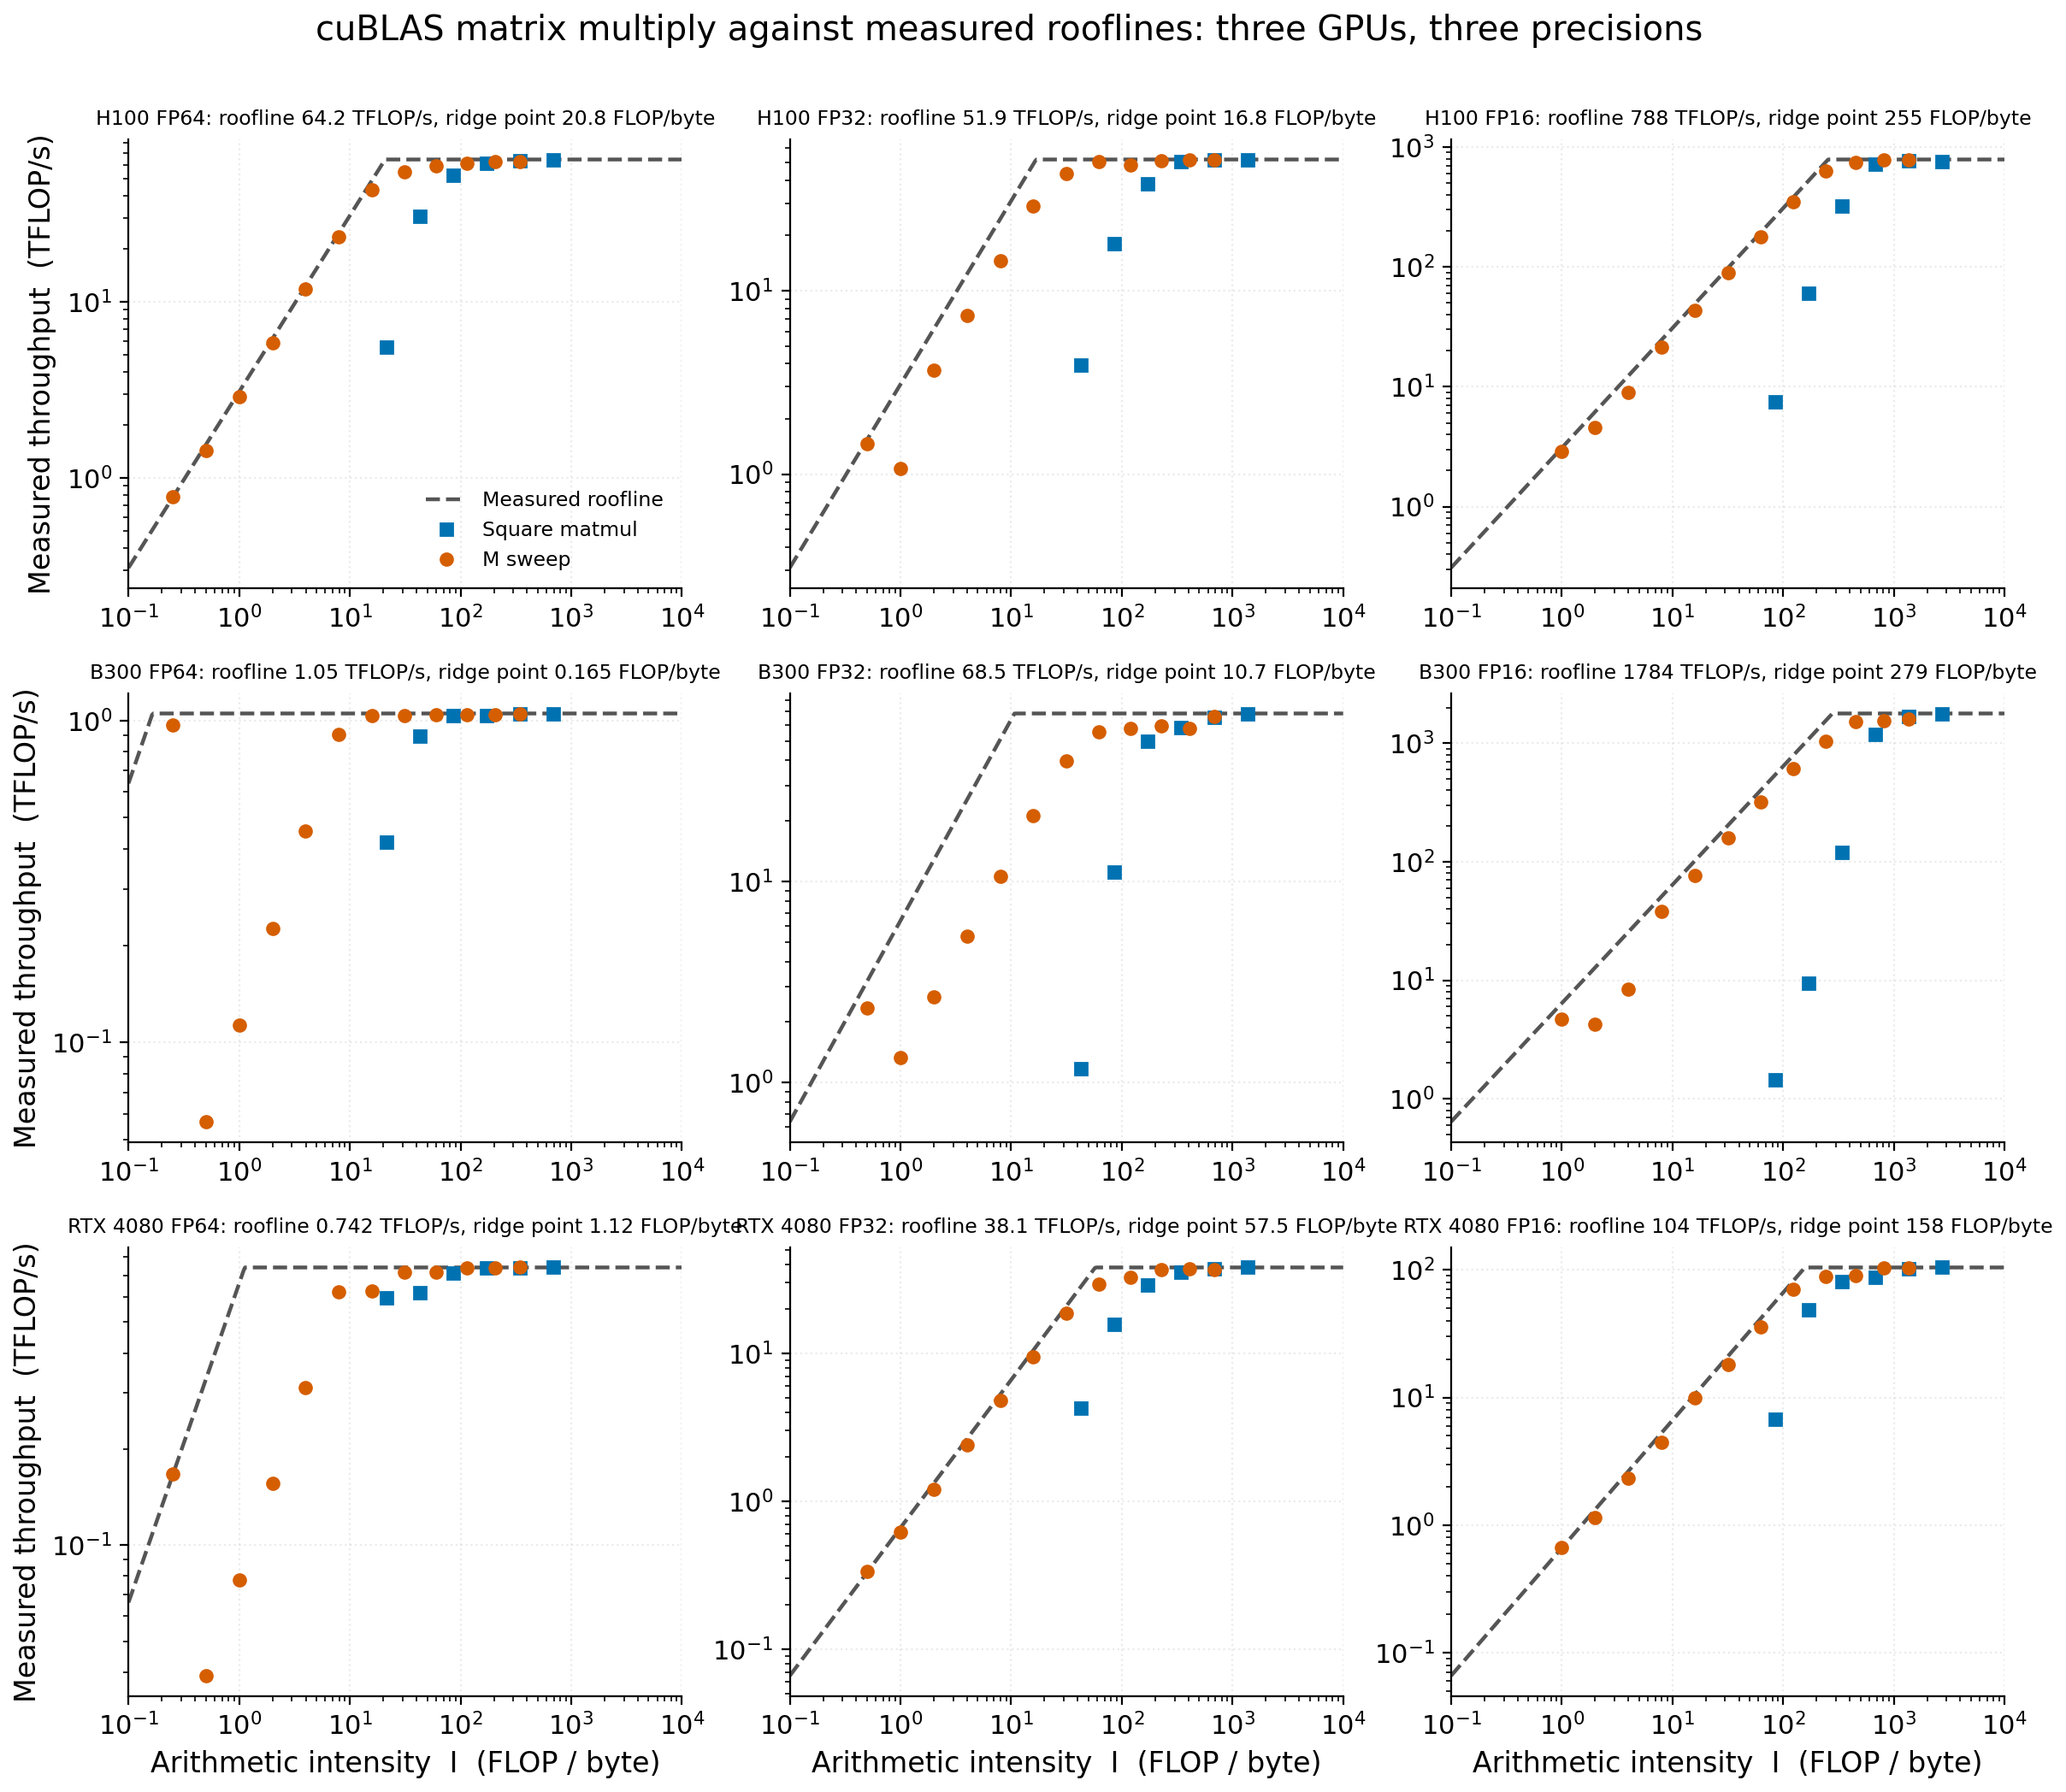

- 每种精度停在自己的平段。 H100 上 FP64 的点停在 64 TFLOP/s,FP32 的点停在 52 TFLOP/s,分别是表 4 里这两条路径的平段。
- B300 FP64 整组都在平段。 它的 ridge point 是 0.16 FLOP/byte,而 \(M = 1\) 时 \(I\) 是 0.25 FLOP/byte。
- 精度越低,点越靠右。 同一行里,同一个 \(M\) 的 \(I = 2M/\text{sizeof}\),sizeof 越小 \(I\) 越大。
M sweep
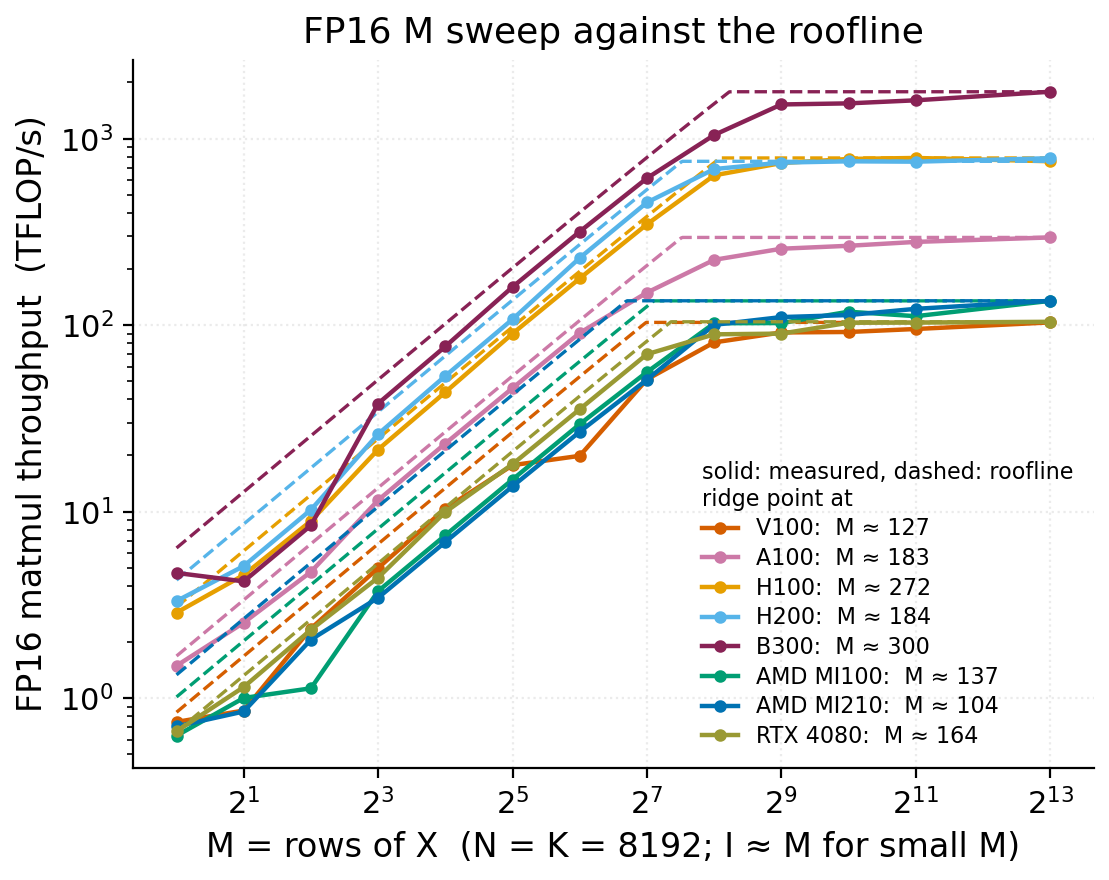
M sweep 固定 \(N = K = 8192\),只改变 \(M\),相当于一个线性层的权重不变、一次送进去的 token 数从 1 增加到 8192。这样同一种矩阵乘的 \(I\) 从约 1 FLOP/byte 增加到几千,从 roofline 的斜段一直走到平段。
图 5 把八张卡 FP16 的 M sweep 单独画出来,横轴直接用 \(M\),即矩阵乘 \(X_{M\times K} \cdot A_{K\times N}\) 中 \(X\) 的行数,对应 LLM 线性层一次送进去的 token 数。\(M\) 不大时 FP16 的 \(I \approx M\),所以横轴读成 \(M\) 和读成 \(I\) 差不多。
每张卡的 ridge point 也换算成了 \(M\),标在图例里:\(M\) 小于这个值时,点在斜段下方;大于这个值时,点在平段下方。
| \(M\) | \(I\) FLOP/byte | throughput TFLOP/s | 达到的带宽 \(Q/T\) GB/s |
|---|---|---|---|
| 1 | 1 | 2.9 | 2875(\(B\) 的 93%) |
| 16 | 16 | 43.7 | 2744 |
| 256 | 241 | 635 | 2637 |
| 2048 | 1365 | 788 | 577 |
表 6:图 5 中 H100 的四个点。
- 转平的位置就是 ridge point。 按 \(I\) 算,H100 转平处与 ridge point 255 FLOP/byte 一致(对应 \(M \approx 272\))。\(M\) 大了以后 \(I\) 小于 \(M\),因为这时 \(M\) 不再远小于 \(K\) 和 \(N\)。
- 斜段上多算几行不花时间。 throughput 随 \(M\) 成比例增长,因为时间几乎不变:每次都要把 8192×8192 的 \(A\)(FP16 下 128 MiB)完整读一遍。在斜段上,时间由读 \(A\) 的字节数决定,多算几行不另外花时间。
- 达到的带宽说明时间花在哪。 用公式算出的 \(Q\) 除以时间,得到的带宽在斜段上一直接近 \(B\),说明时间花在搬数据上;\(M = 2048\) 进入平段后,时间由运算决定,达到的带宽降到 577 GB/s。
离 roofline 较远的点
图 4、图 5 里也有离 roofline 较远的点。roofline 只给出上界,离上界多远取决于 kernel 的实现,主要有四种情况:
- 小方阵:launch overhead。 H100 上 FP16 的 \(n = 256\) 和 \(n = 512\) 方阵都用 4.5 µs,运算量差 8 倍而时间相同,时间几乎全是第 4 节说的 launch overhead。很多个小矩阵乘要算时,把它们放进一个 kernel 一起算(cuBLAS 的 batched 接口),这份开销只付一次。
- 小 \(M\):cuBLAS 选的 kernel。 H100 FP16 在 \(M = 4\) 时用 0.060 ms,比 \(M = 8\) 的 0.050 ms 长。cuBLAS 对不同的 \(M\) 选用不同的 kernel:\(M = 1\) 是 GEMV,有专门的 kernel;\(M = 2\) 和 4 选到的通用 kernel 效率较低。B300 FP16 的 \(M = 2\) 和 4 也是这样。所以在这两张卡上,\(M = 2\) 或 4 的矩阵乘补到 8 更快,B300 上快一倍多(0.064 → 0.028 ms)。
- 平段附近也有同类现象。 RTX 4080 FP16 在 \(M = 256\) 到 512 停在 90 TFLOP/s,\(M = 1024\) 时到 103。
- FP32 和 FP64 的小 \(M\) 点低得更多,而且在一段 \(M\) 内时间完全不变,原因不同,第 7 节单独讲。
6. LLM 推理:prefill 与 decode
LLM 推理(inference,用训练好的模型根据输入生成文本)的运算和权重读取主要集中在线性层。按第 2 节,线性层的 \(I\) 由一次送进去的 token 数 \(M\) 决定。推理分两个阶段:
- prefill:一次送进整段输入。 把输入的 prompt(输入文本)整段算一遍,\(M\) 等于 batch(同时处理的请求数)乘以 prompt 的 token 数。\(M\) 达到几百以后,\(I\) 就超过 H100 的 \(I^*\),所以输入较长时 prefill 是 compute-bound。
- decode:每步送进 1 个新 token。 生成第 \(t+1\) 个 token 要用第 \(t\) 个 token 作输入,而第 \(t\) 个 token 要等上一步算完才知道,所以每步每个请求只能送进 1 个新 token;更早 token 的中间结果(KV cache)已经存下来,不用重算。\(M\) 等于 batch,batch = 1 时 \(I \approx 1\) FLOP/byte,所以 decode 是 memory-bound。
一层里的七个线性层
下面用一个具体的模型看这两个阶段的点落在哪里。模型是 Qwen2.5-7B(名义 70 亿参数,实际约 76 亿),共 28 层,每层结构相同,取中间的第 14 层。这一层有七个线性层:q、k、v、o 属于 attention 部分,gate、up、down 属于 MLP 部分,它们的 \(N\) 各不相同。
用 Nsight Compute(NVIDIA 的 kernel 性能分析工具,即 profiler,能读硬件计数器)在 H100、H200、RTX 4080 上测这七个 kernel。横轴是 \(2MNK\) 除以计数器测到的显存字节数,也就是用实际流量算的 \(I\);纵轴是 \(2MNK\) 除以 kernel 时间。
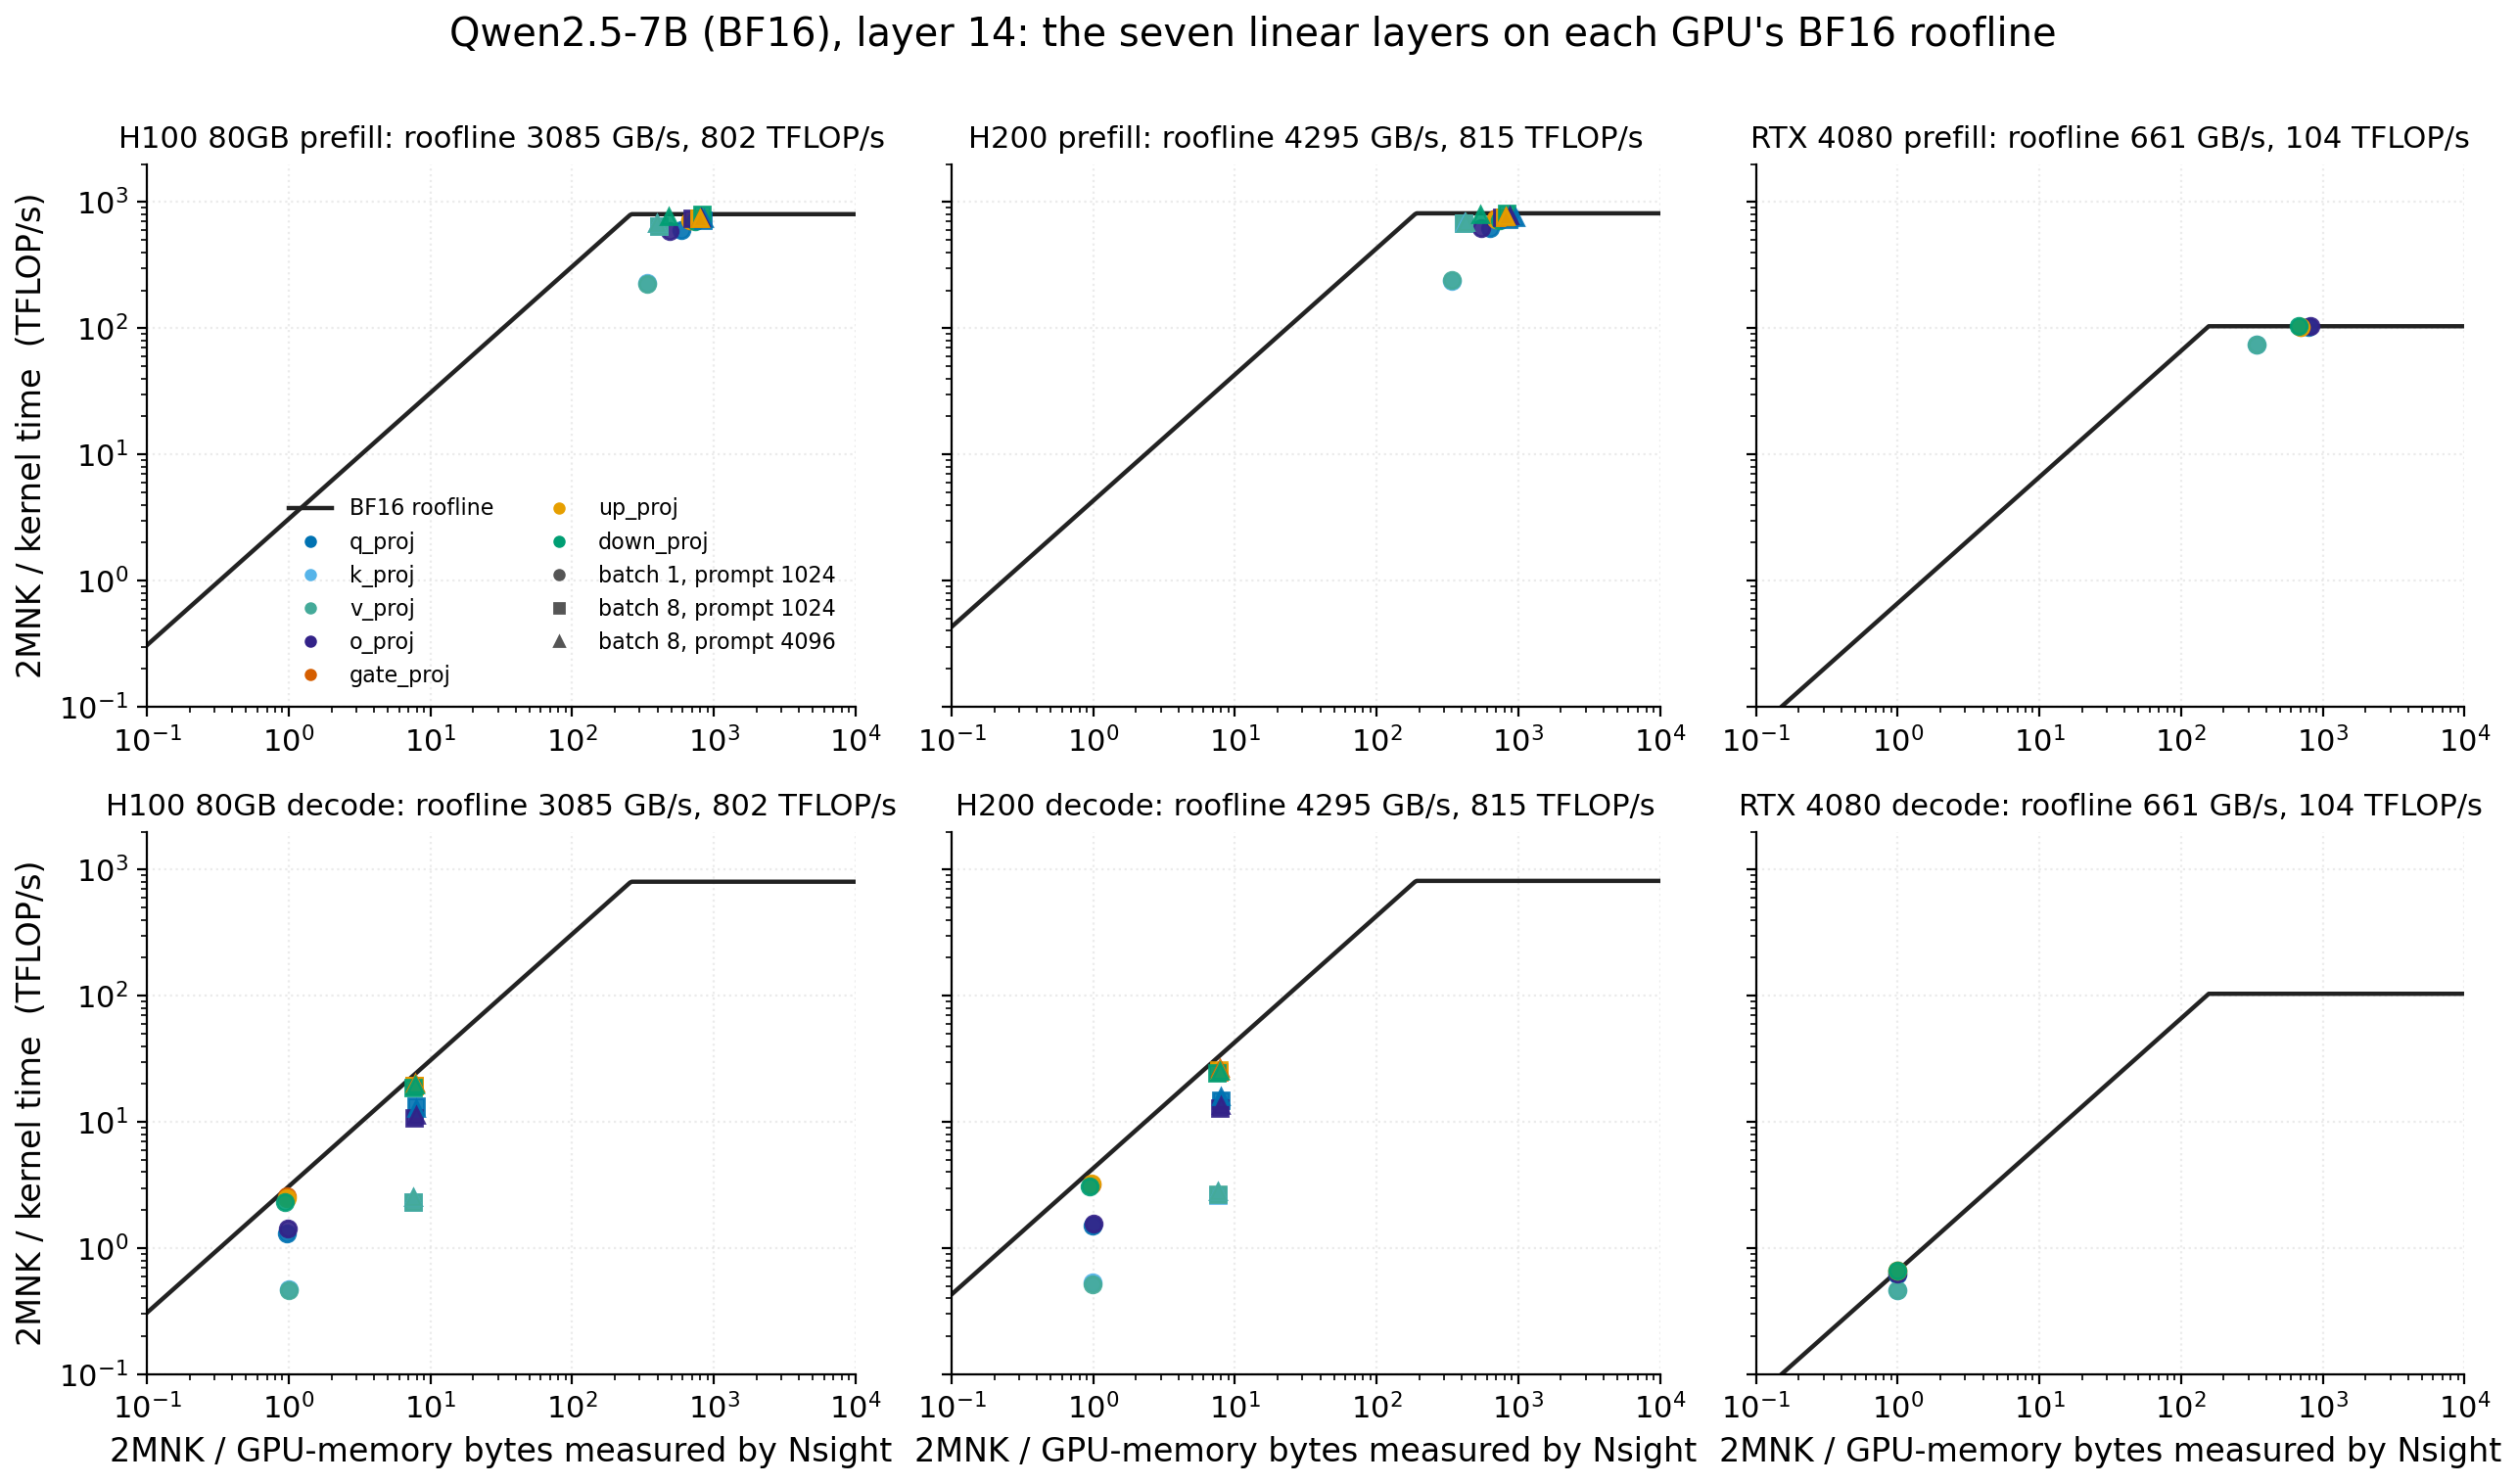
- prefill 接近平段。 H100 上 \(I\) 在 340 到 850 FLOP/byte 之间,都大于 BF16 的 \(I^* = 260\) FLOP/byte。除 batch 1 的 k、v 外,throughput 在 588 到 794 TFLOP/s,接近 802 的平段。BF16 的 \(F\) 也要单独测:H100 是 802 TFLOP/s,H200 是 815 TFLOP/s,和 FP16 的 788、756 TFLOP/s 都不同。
- decode 接近斜段。 batch 1 时 \(I \approx 1\) FLOP/byte,batch 8 时 \(I \approx 8\) FLOP/byte,和第 2 节的计算一致。H100 上 gate、up、down 三个最大的矩阵达到斜段的 80% 以上,q、o 约一半;RTX 4080 上除 k、v 外都达到 93% 以上。
- k 和 v 离 roofline 最远。 它们的输出维度是 512(q 和 o 是 3584),是七个里最小的矩阵,kernel 的 launch overhead 占比最大。
decode 每步的时间下界
一步 decode 由一连串 kernel 组成。每个 kernel 的时间都不低于它自己的 \(Q/B\),加起来,一步的时间不低于这一步搬运的总字节数除以 \(B\)。prompt 不长时,其余的读写都很小,最大的一项是权重,每步都要完整读一遍:
\[T_\text{decode} \ge \frac{Q_\text{weights}}{B}\]其中 \(Q_\text{weights} = 15.23 - 1.09 = 14.14\) GB。15.23 GB 是 Qwen2.5-7B 全部参数在 BF16 下的大小,1.09 GB 是其中的输入 embedding 表(把 token 编号映射成向量的查找表),每步只读其中一行,可以不计。
下面的 decode 时间用 Hugging Face Transformers(常用的模型推理库)逐步运行模型测得,prompt 128 token,每个 kernel 由 CPU 逐个发出,不经过 vLLM 这类推理框架。
| GPU | \(B\) GB/s | 下界 ms | 实测 ms | 下界 ÷ 实测 |
|---|---|---|---|---|
| RTX 4080 | 661 | 21.4 | 24.3 | 88% |
| H100 80GB | 3085 | 4.58 | 11.56 | 40% |
| H200 | 4295 | 3.29 | 11.86 | 28% |
表 7:batch = 1 时 decode 每步的带宽下界与实测时间。
batch = 1 时的算力利用率
batch = 1 时,一步的运算量很小。除 embedding 外,权重有 14.14 GB ÷ 2 字节 = 70.7 亿个,每个做一次乘加,\(W \approx 141\) 亿 FLOP。在 H100 上 \(W/F\) 是 0.018 ms,不到带宽下界 4.58 ms 的 1/250。每个权重读进来只做一次乘加,H100 的算力用到不足 1%。
公式指出了办法。batch 为 \(b\) 时,每步送进 \(b\) 个 token,\(M = b\):权重仍然每步读一遍,\(Q\) 几乎不变,\(W\) 变成 \(b\) 倍,\(I \approx b\)。只要 \(I\) 还在 ridge point 左边,时间就仍由读权重决定,多生成的 token 几乎不另外花时间,这就是第 5 节斜段上“多算几行不另外花时间”。只看权重的话,H100 BF16 的 \(I^* = 260\) FLOP/byte,batch 到两百多之前都是这样;每个请求的 KV cache 也要每步读一遍,batch 和 prompt 大了以后不能再忽略。
实验也是这样。图 6 下行里,batch 从 1 到 8,decode 的点沿斜段从 \(I \approx 1\) 移到 \(I \approx 8\) FLOP/byte,throughput 跟着上升。图 7 是每步时间随 batch 的变化。
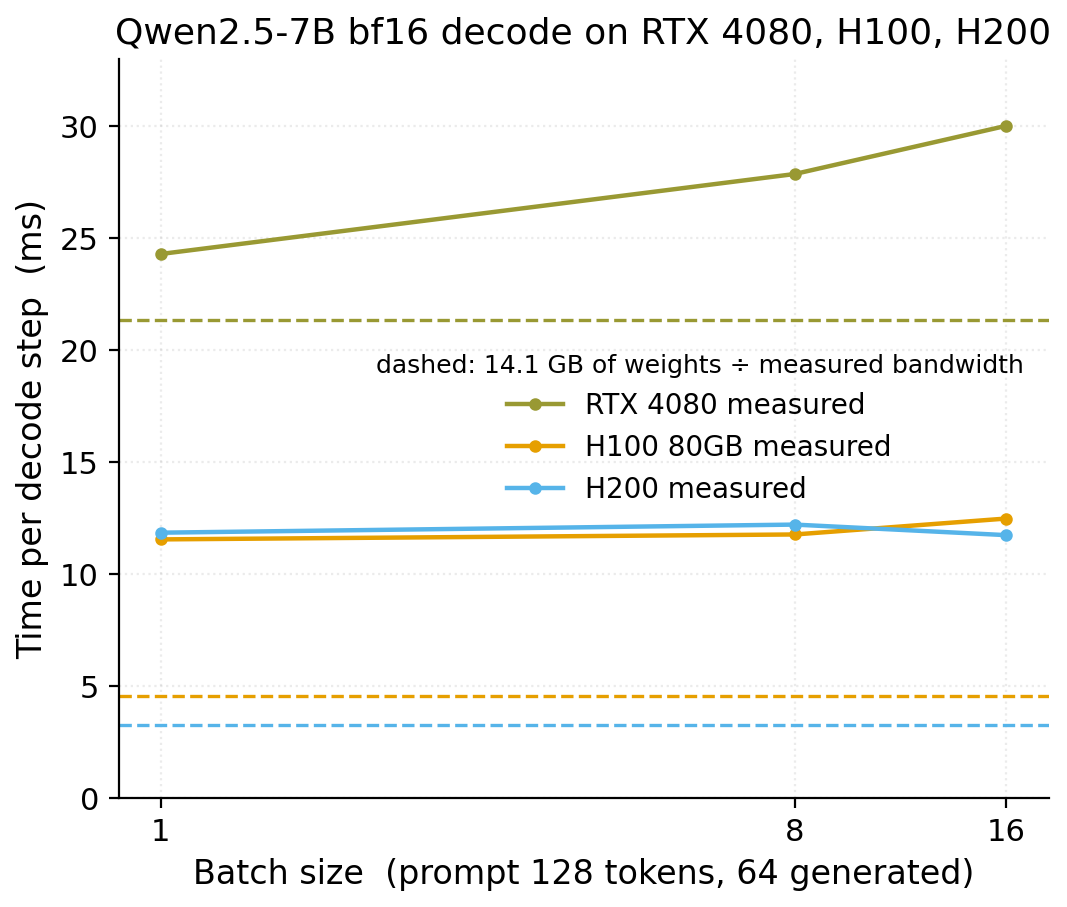
batch 从 1 增大到 16,每步多生成 15 个 token,H100 每步时间增加 8%(11.56 → 12.50 ms),RTX 4080 增加 24%(24.3 → 30.0 ms),平均到每个 token 的时间都降了一个数量级。RTX 4080 多出的 24% 本文没有逐个 kernel 拆分;H200 在 batch 16 时略快于 batch 1,差别在测量波动之内。
这个收益随 prompt 变长而变小。H100 上 batch 从 1 增大到 16,prompt 为 1024 token 时每步时间增加 93%(11.49 → 22.14 ms),4096 token 时变成 4.4 倍(12.55 → 54.81 ms);平均到每个 token,时间分别降到 1/8 和 1/3.7。原因是每个请求的 KV cache 每步都要读一遍,它的大小和 batch 与 prompt 长度的乘积成正比,prompt 长时不能再忽略。
实测比下界多出的时间
表 7 里,RTX 4080 贴近下界,读权重占了每步时间的 88%;H100 和 H200 的实测是下界的 2.5 到 3.6 倍。如果多出的时间也花在搬数据上,带宽多 39% 的 H200 应该更快,实测两张卡几乎一样(11.56 对 11.86 ms)。所以多出的时间花在搬数据之外。
最可能的原因是 CPU 发出 kernel 的速度。一步要发出一千多个 kernel(28 层,每层约 44 个),CPU 发出每个 kernel 都要花一段时间。H100 和 H200 上许多 kernel 执行得比 CPU 发出下一个还快,GPU 就要空等;RTX 4080 读权重本身就慢,CPU 来得及提前发出后面的 kernel,空等就少。vLLM 等推理框架用 CUDA Graph 把一步的 kernel 一次提交,就是为了去掉这部分开销。H100 多出的约 7 ms、H200 多出的约 8.6 ms 具体花在哪里,要用 profiler 看 kernel 之间的空隙才能确认。
7. 模型的适用范围
模型有三条边界,每条都能在数据里找到例子:
| 边界 | 数据里的例子 |
|---|---|
| roofline 的 \(B\) 是显存带宽,数据从 L2 读到时点可以高过 roofline | RTX 4080 FP8 的点高出 roofline 近一倍(图 8) |
| 硬件实际执行的运算可能多于 \(2MNK\) | RTX 4080 FP64 从 \(M = 2\) 到 32 时间都是 6.89 ms(图 9) |
| Roofline 只管单个 kernel | decode 每步比带宽下界多 3 到 9 ms(第 6 节) |
表 8:模型的三条边界。
数据从 L2 读到
RTX 4080 上 FP8(1 字节一个元素)的 M sweep,\(M = 16\) 到 64 时 throughput 是 roofline 的 1.8 到 2 倍。用公式算出的 \(Q\) 计算,带宽有 1200 到 1300 GB/s,接近显存带宽的 2 倍,只能是一部分数据直接从 L2 读到:FP8 下 \(A\) 是 64 MiB,和 L2 一样大,连续重复执行时会留在 L2 里。
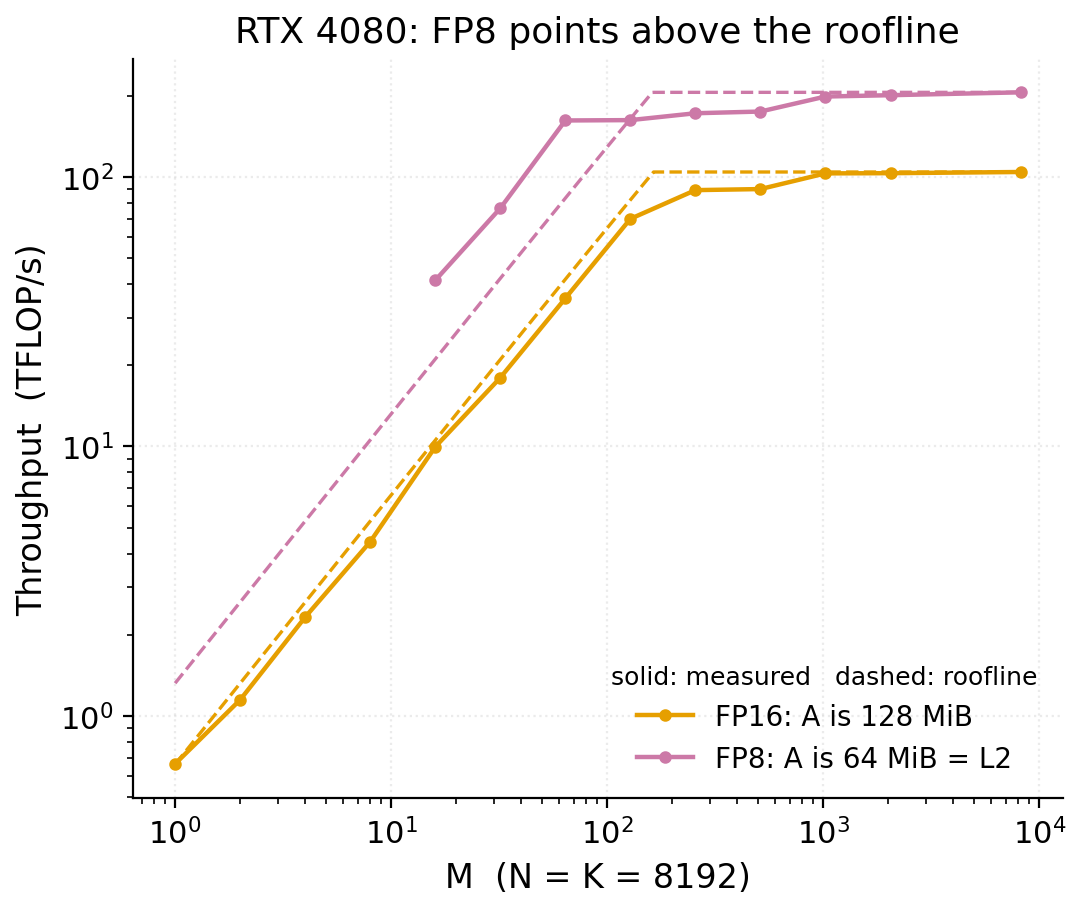
working set 装得进 L2 时,实际的显存流量小于公式算出的 \(Q\),用公式算出的 \(Q\) 画的点可以高过 roofline。这时要用 profiler 测到的实际显存流量重算 \(I\)。
执行的运算多于有用的运算
RTX 4080 的 FP64 在 \(M = 2\) 到 32 时间都是 6.89 ms,B300 的 FP32 在 \(M = 2\) 到 32 都是 0.20 ms。cuBLAS 的 kernel 把矩阵切成固定行数的块来算,\(M\) 不足一块时也按整块算,即 padding。\(M = 1\) 时改用 GEMV 的 kernel,不受影响。
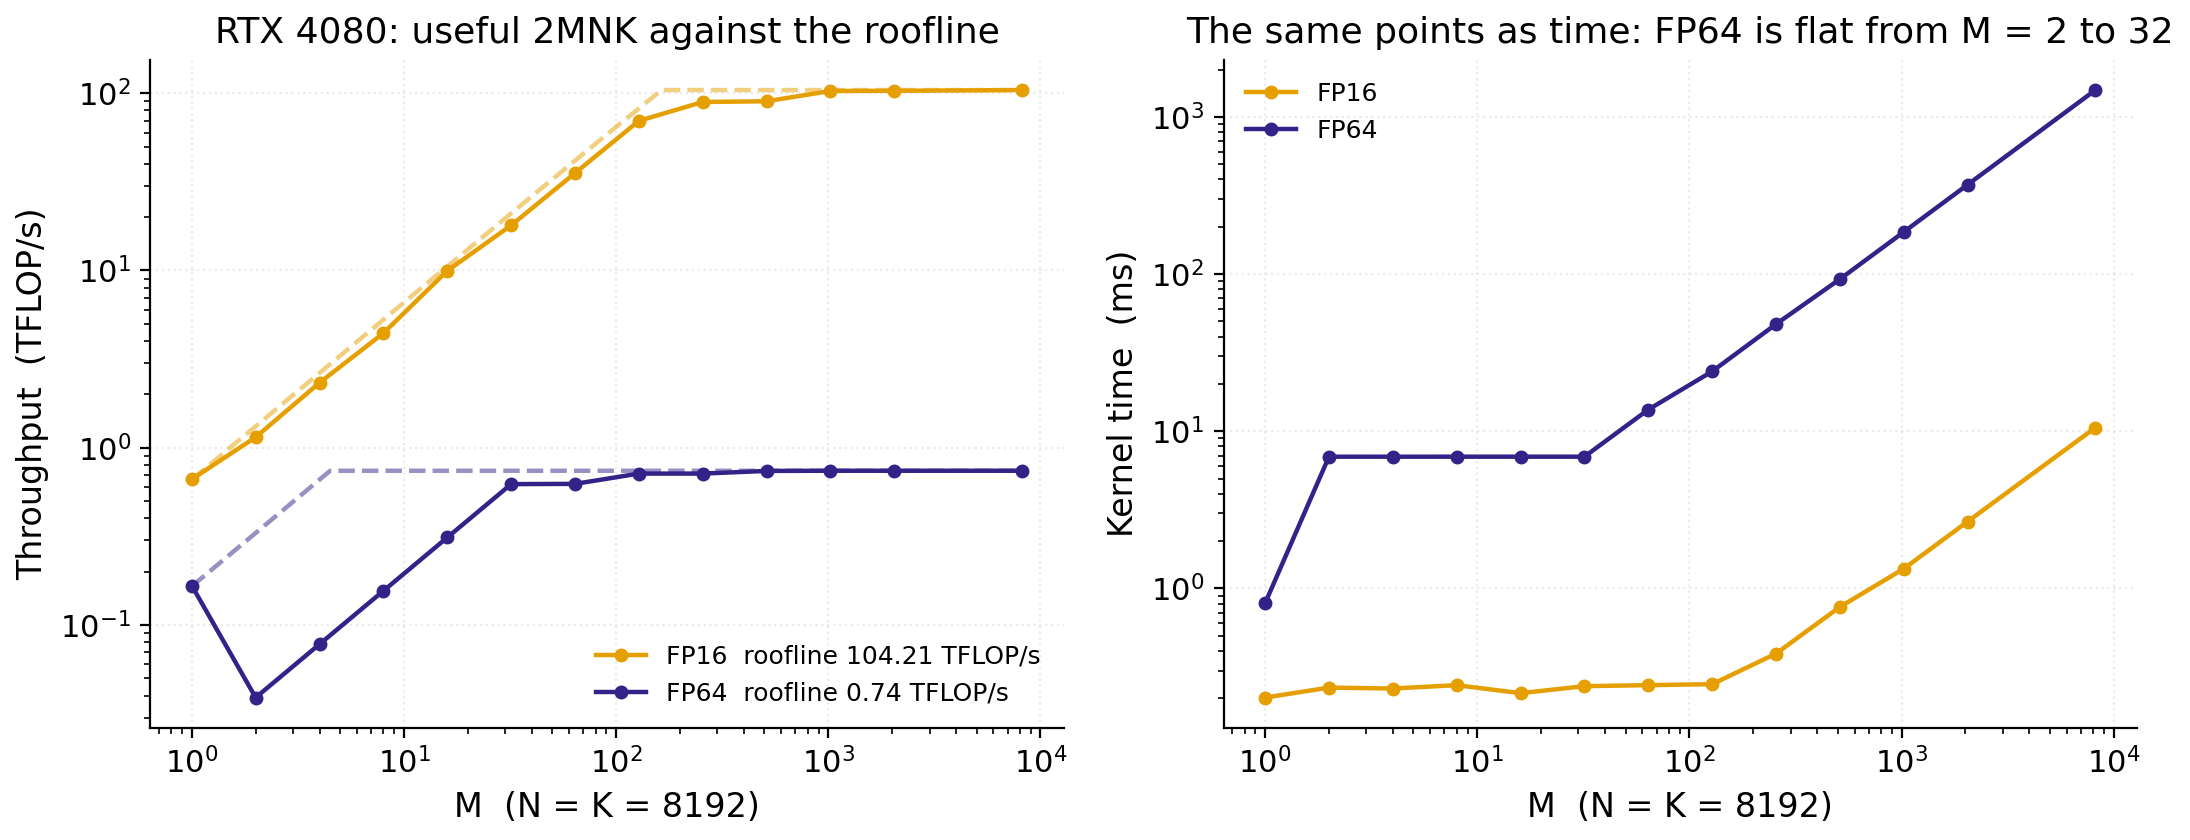
以 \(M = 2\) 为例,RTX 4080 的 FP64 kernel 实际算了 32 行,有用的是 2 行,按有用运算量算出的 throughput 是实际执行的 throughput 的 1/16。FP16 即使同样 padding 到 32 行,\(I\) 约为 32 FLOP/byte,仍在 RTX 4080 的 ridge point 158 FLOP/byte 左边,时间由读 \(A\) 决定,多算的行不占时间;FP64 在 RTX 4080 上的 ridge point 是 1.12 FLOP/byte,padding 后多出的运算直接决定时间。所以 padding 只在 padding 后的 \(I\) 超过 ridge point 时拖慢 kernel。
单个 kernel 之外的时间
Roofline 是单个 kernel 的模型。一个程序由许多 kernel 组成,它的时间除了各 kernel 自身的时间,还包括 kernel 之外的开销(overhead),例如 Python 解释器和框架代码的执行、CPU 发出每个 kernel 的时间、CPU 与 GPU 之间的同步。
PyTorch 这类框架是异步执行的:GPU 运行一个 kernel 时,CPU 已经在发出后面的 kernel。kernel 足够大时,这些开销被 GPU 的执行时间掩盖;kernel 很小、数量很多时,GPU 执行得比 CPU 发出得快,就会闲着等待,程序的时间由 CPU 一侧决定。第 6 节 decode 每步实测比带宽下界多出的时间,既包括各 kernel 没有达到 roofline 的部分,也包括 kernel 之外的开销,各占多少要用 profiler 看 kernel 的时间线才能分清。
8. 总结
- 一个 kernel 的时间下界是 \(\max(W/F,\ Q/B)\)。比较 \(W/Q\) 和 \(F/B\),就知道它受带宽还是算力限制。
- \(W/Q\) 由运算的形状和精度决定,可以由公式直接算出;\(F/B\) 要按 kernel 实际使用的运算路径取,H100 上从 10.7 到 255。
- 受带宽限制的 kernel,要减少搬运的字节、提高 \(I\);受算力限制的 kernel,要换到更高的平段,例如 Tensor Core 或更低的精度。
- 实测点离 roofline 很远时,原因在模型之外:launch overhead、cuBLAS 选的 kernel、padding、kernel 之间的空等。
- LLM 推理中,prefill 落在平段下方,decode 落在斜段下方。decode 每步至少读一遍权重,batch 越大,这次读取由越多 token 分摊。
全部数据表、benchmark 源码、画图脚本和 decode 计时脚本都在配套仓库里。